SEO / ROBOTS.TXT / CRAWLING
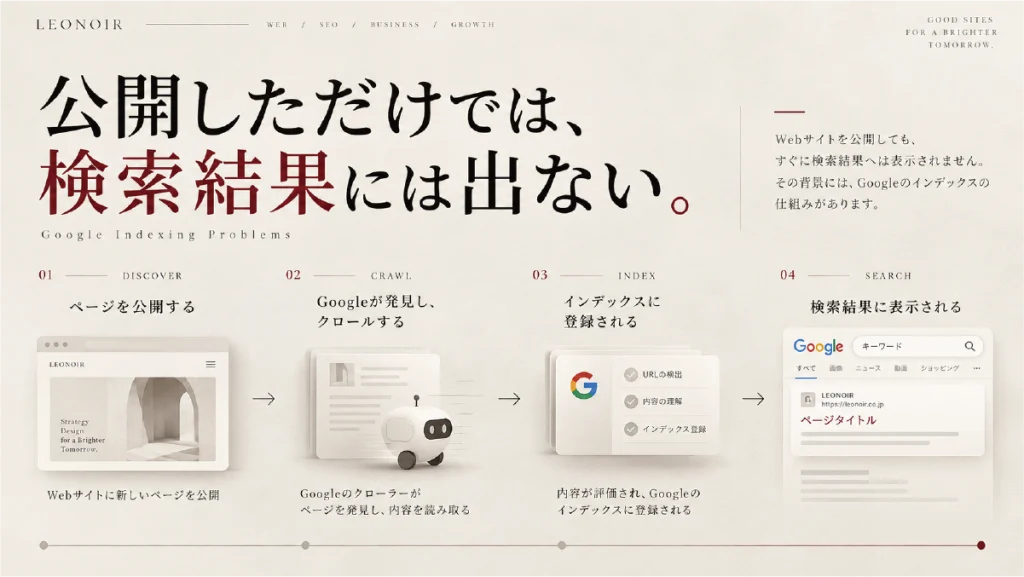
Googleは、 Webサイト内のURLを見つけると、 Googlebotなどのクローラを使ってページを取得します。
しかし、 サイト内のすべてのURLを クロールしてほしいとは限りません。
管理画面、 内部検索結果、 不要なパラメータURLなど、 クロールさせる必要がないURLもあります。
そのとき使われるのが、 robots.txtです。
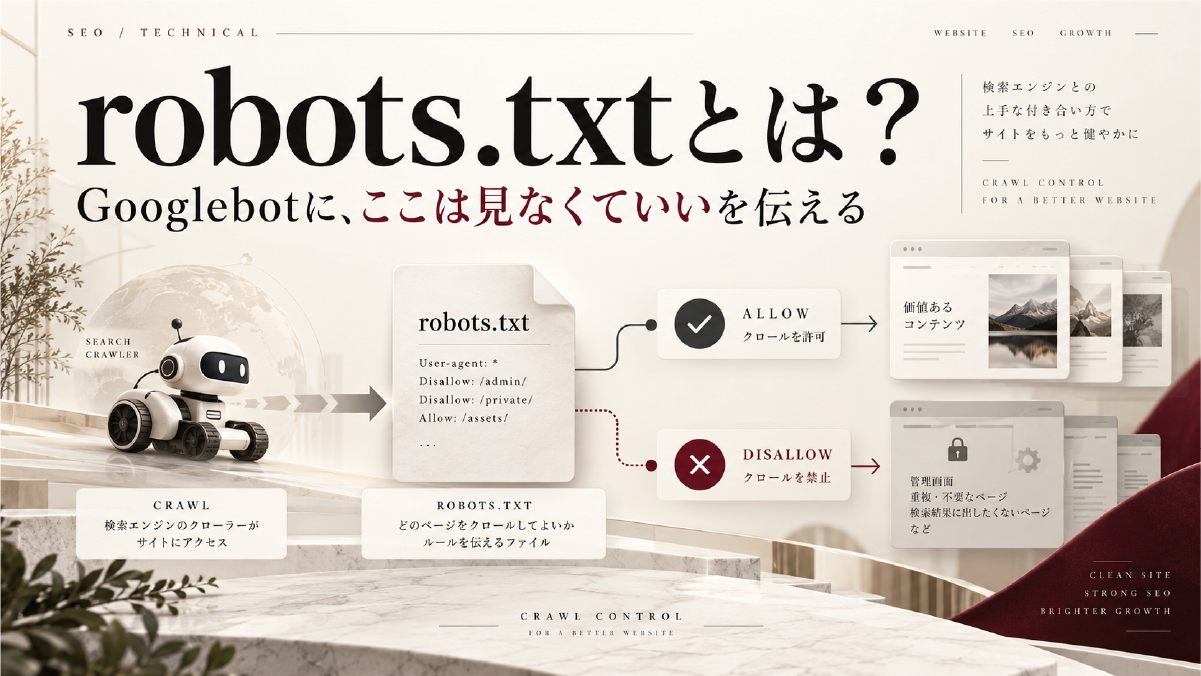
robots.txtは、 検索エンジンのクローラに対して、 どのURLやディレクトリをクロールしないでほしいかを伝えるファイル です。
この記事では、 robots.txtの基本、 書き方、 noindexとの違い、 WordPressでの注意点、 Search Consoleでの確認方法まで整理します。
robots.txtとは?
robots.txtは、 検索エンジンのクローラに対して、 クロールしてほしくないURLやディレクトリを伝えるためのテキストファイルです。
通常は、 ドメイン直下に配置されます。
たとえば、 example.comの場合は、 https://example.com/robots.txt というURLになります。
Googlebot
サイトへ クロールに来る。
ルール確認
クロール可能な URLを確認する。
許可
ページを クロールする。
制限
指定URLを クロールしない。
robots.txtは、 検索順位を直接上げる設定ではなく、 クローラのアクセス範囲を整理するための仕組み です。
robots.txtは
何を制御する?
robots.txtが制御するのは、 基本的に検索エンジンによるクロールです。
サイト内に、 クロールさせる必要がないURLが大量に存在する場合、 不要なクロールを抑えるために使われます。
一方で、 一般的な小規模サイトでは、 必ずしも複雑なrobots.txtを用意する必要はありません。
管理系URL
クロールする必要がない 管理画面など。
大量のパラメータ
不要なURLが 大量生成される場合。
内部検索
サイト内検索結果など クロール不要なURL。
クロール整理
重要なページへ クロールを集中させる。
robots.txtの
基本的な書き方
robots.txtでは、 主にUser-agentとDisallowを使って クロールルールを記述します。
User-agent: *
Disallow: /private/対象クローラ
「*」なら 対応するすべてのクローラを対象とします。
クロール禁止
指定したパスを クロールしないよう伝えます。
Disallow: /admin/
Disallow: /search/
Disallow: /private/
Disallow:
robots.txtと
noindexは違う
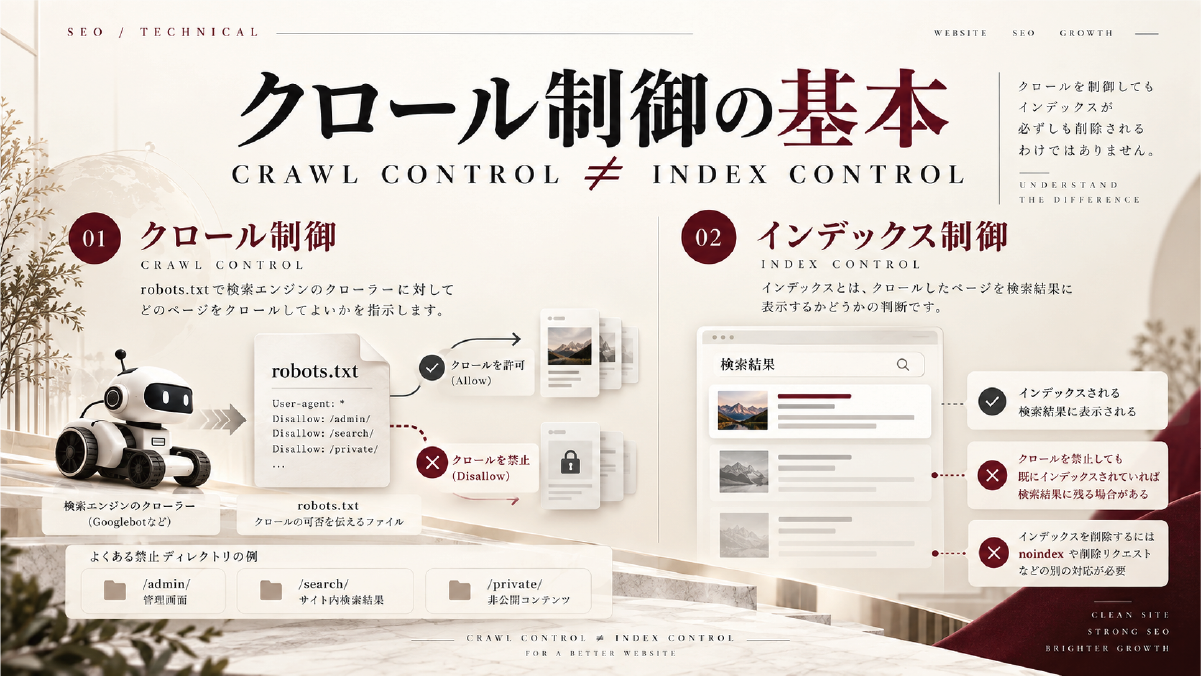
robots.txtとnoindexは、 混同されやすい設定です。
しかし、 役割は明確に異なります。
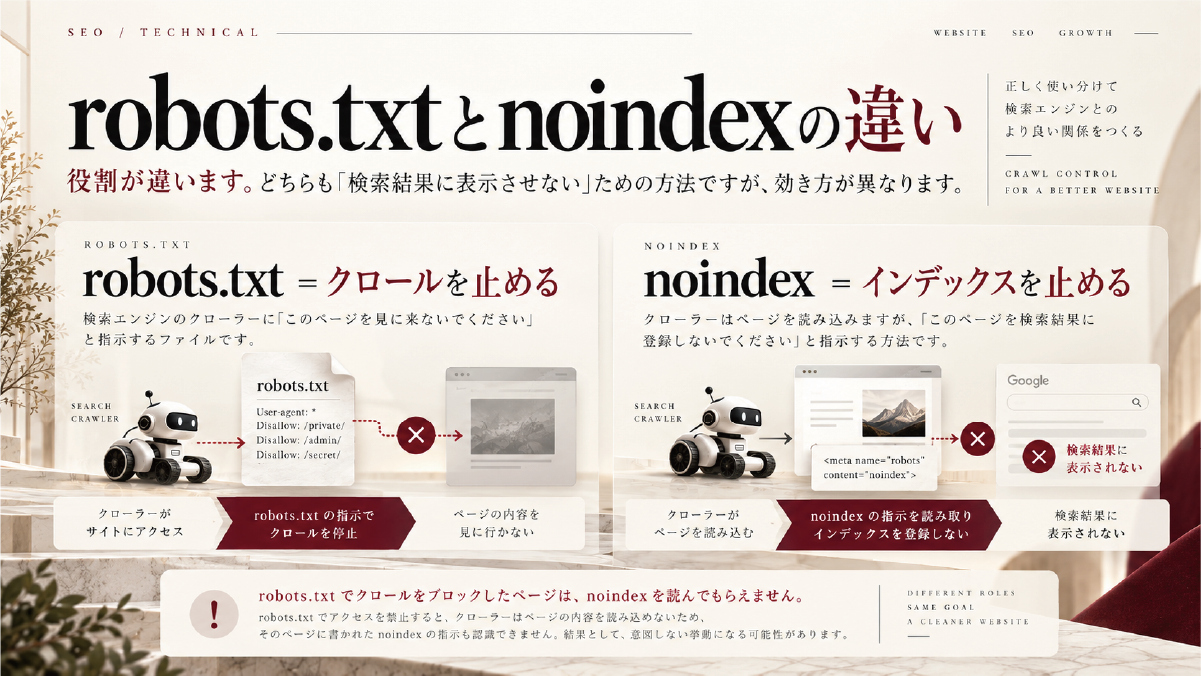
クロールを止める
Googlebotが ページ内容を取得しないよう制御します。
インデックスを止める
Google検索結果へ ページを登録しないよう伝えます。
robots.txtでページをブロックすると、 Googleがそのページ内の noindexを読み取れない場合があります。
CSS・JavaScriptを
むやみに止めない
Googleは、 ページをユーザーに近い状態で理解するために、 HTMLだけでなくCSSやJavaScriptなどのリソースも利用します。
ページの意味や表示に必要なリソースを robots.txtでブロックすると、 Googleがページを正しく理解しにくくなる場合があります。
本文
ページ内容
表示
レイアウト
動作
レンダリング
ページ理解
Googleが解析
「不要そうだから止める」ではなく、 Googleがページを理解するために必要なリソースか を確認してから設定します。
WordPressで
注意したいポイント
WordPressでは、 サーバー上にrobots.txtファイルを置いていなくても、 仮想的なrobots.txtが表示される場合があります。
また、 サイト公開時に検索エンジンへの表示設定や SEOプラグインの設定が影響することもあります。
robots.txtだけを見るのではなく、 noindexやサイト全体の公開設定もあわせて確認します。
/robots.txt を実際に開く
WordPressの公開設定を確認
SEOプラグインを確認
noindexも確認
サイトマップも確認
Search Consoleで確認
robots.txtから
サイトマップを伝える
robots.txtには、 XMLサイトマップのURLを記述することもできます。
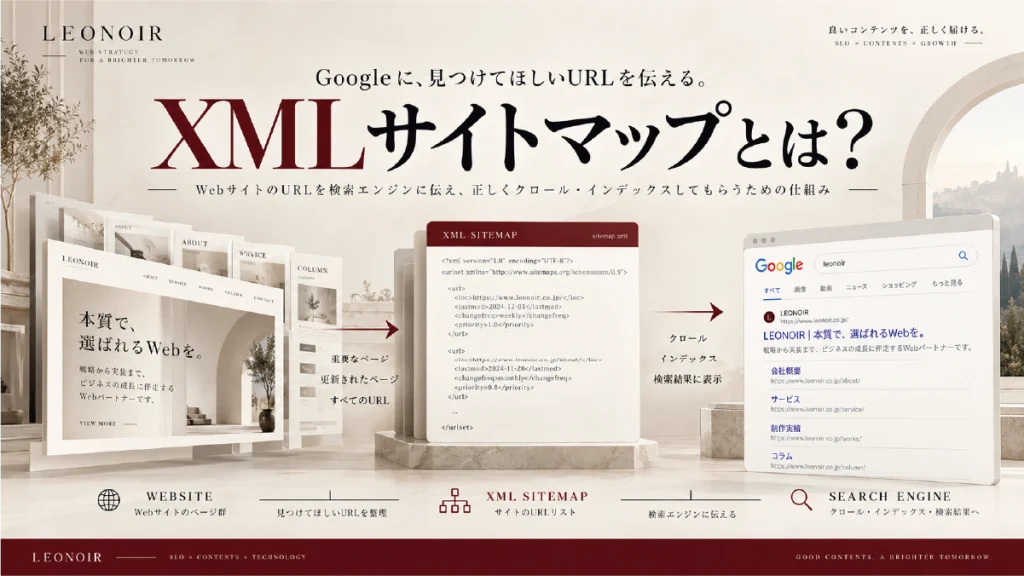
robots.txtとXMLサイトマップは 役割が異なりますが、 どちらもクロール設計の一部として確認します。
User-agent: *
Disallow:

Sitemap: https://example.com/sitemap.xmlクロール範囲
どこをクロールしないかを伝える。
重要URL
見つけてほしいURLを伝える。
Search Consoleで
robots.txtを確認する
robots.txtを変更したら、 ブラウザ上で表示できるかを見るだけでなく、 Googleがどのrobots.txtを認識しているかも確認します。
Search Consoleのrobots.txtレポートでは、 Googleが検出したファイルや、 最終クロール日、 警告・エラーなどを確認できます。
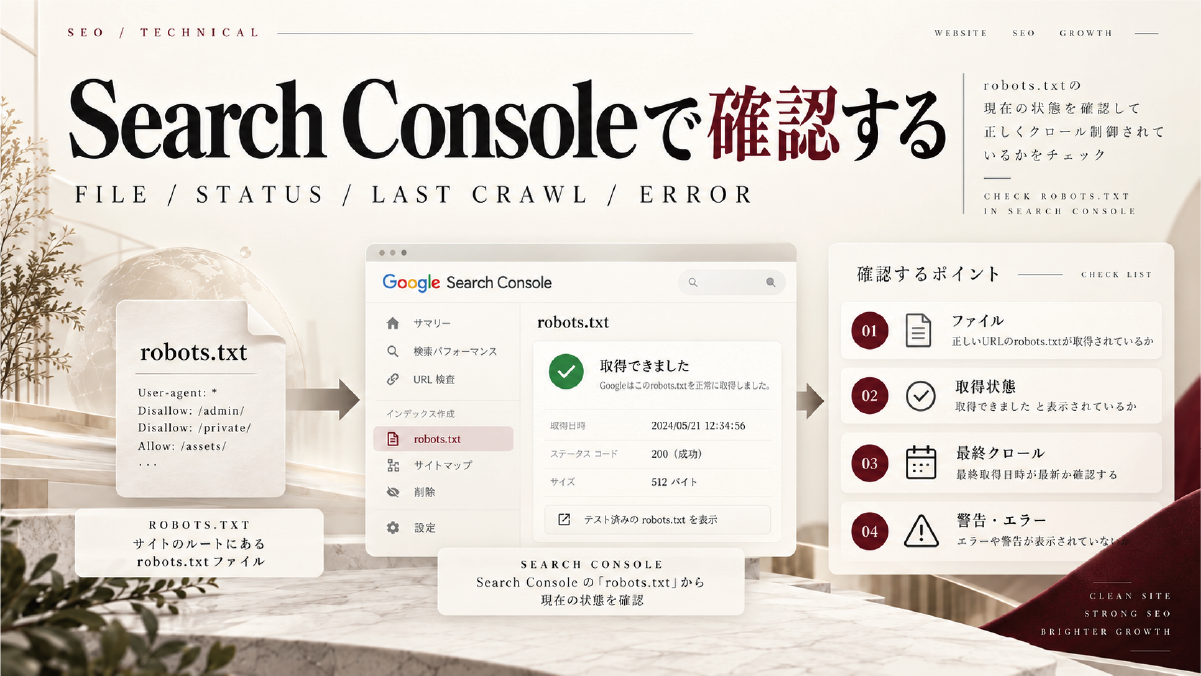
ファイル
Googleが認識している robots.txtを確認。
取得状態
正常に取得 できているか。
最終クロール
最後にGoogleが 取得した時点を確認。
警告・エラー
構文や取得上の 問題を確認。
robots.txtで
よくある設定ミス
サイト全体をブロック
公開後も Disallow: / が残っている。
noindex代わりに使う
検索結果から消す目的で robots.txtを使う。
CSS・JSを止める
ページ表示に必要な リソースをブロックする。
パスを誤る
意図しない ディレクトリまで止める。
本番反映後に未確認
Googleが認識した robots.txtを見ていない。
サーバーエラー
robots.txt取得時に 5xxなどを返している。
robots.txtは、 「止めた方が安全」ではなく、 本当にクロール不要なURLだけを制御する という考え方が基本です。
robots.txtについて
よくある質問
robots.txtはSEOに必要ですか? +
すべてのサイトで複雑な設定が必要なわけではありません。 小規模サイトでは、 クロールを制御する必要がほとんどない場合もあります。
robots.txtでページを検索結果から消せますか? +
検索結果から除外するための仕組みとしては適していません。 robots.txtは主にクロール制御に使い、 検索結果に表示させたくないページでは noindexなど適切な方法を使います。
robots.txtとnoindexはどちらが強いですか? +
強弱で比べるものではなく、 役割が異なります。 robots.txtはクロール制御、 noindexはインデックス制御です。
robots.txtにサイトマップを書く必要がありますか? +
XMLサイトマップの場所を robots.txt内で伝えることができます。 Search Consoleからサイトマップを送信する方法と併用できます。
robots.txtがないとGoogleはクロールできませんか? +
robots.txtは必須ではありません。 robots.txtが存在しないこと自体が クロールを禁止する意味になるわけではありません。
robots.txtを変更したらすぐ反映されますか? +
Googleがrobots.txtを再取得するまで タイムラグが生じる場合があります。 Search ConsoleでGoogleが認識している状態を確認します。
SUMMARY
検索から消すのではなく、
クロールする範囲を整える。
robots.txtは、 検索エンジンのクローラに対して クロールしてほしくないURLを伝えるためのファイルです。
ただし、 検索結果からページを消すための仕組みではありません。
robots.txt、 noindex、 canonical、 XMLサイトマップには それぞれ異なる役割があります。
何を制御したいのかを整理したうえで、 必要なURLだけを適切に設定し、 Search ConsoleでGoogleの認識まで確認することが重要です。
目的確認
クロール整理
noindexと区別
設定確認
Googleで確認
Googleが読みやすい、
サイト構造へ。
LEONOIRでは、 robots.txt・XMLサイトマップ・canonical・インデックスなどの 技術的なSEOから、 コンテンツ・内部リンク・サイト構造まで Webサイト全体の改善をご相談いただけます。