SEO / INDEXING / SEARCH CONSOLE
記事やページを公開したのに、 Google検索で見つからない。
そんなとき、 すぐに「SEO評価が低い」と判断するのは早すぎます。
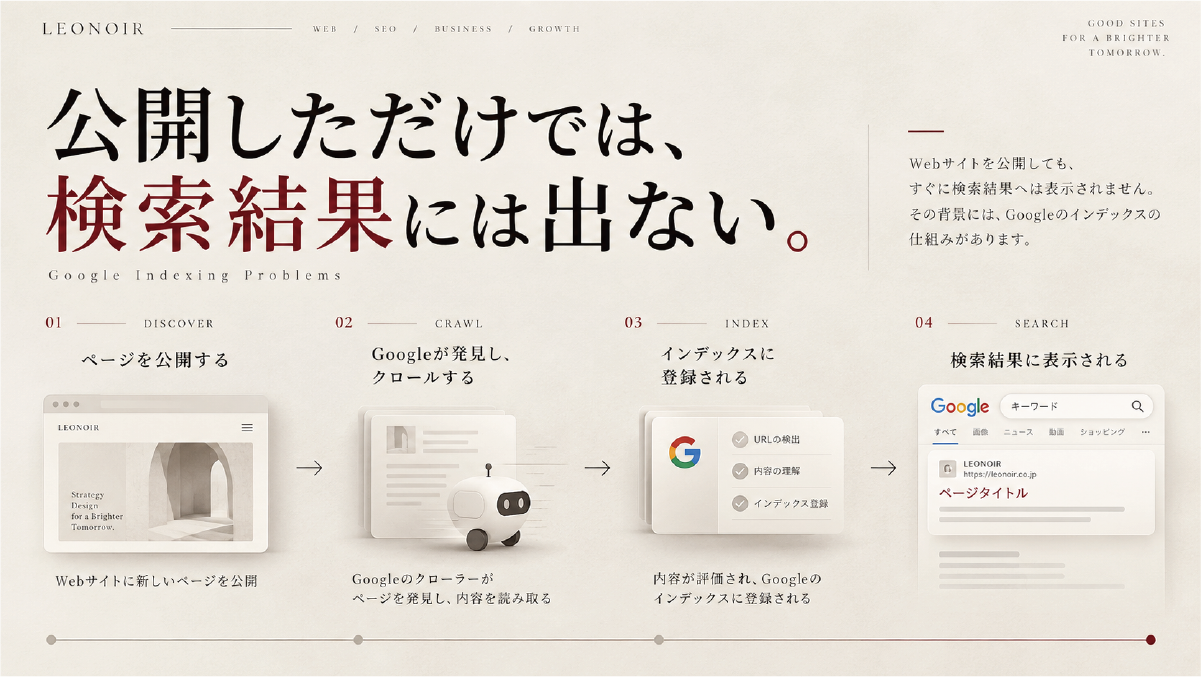
Googleにページが表示されるまでには、 ページを発見し、 クロールし、 内容を確認し、 インデックスへ登録する流れがあります。
つまり、 どの段階で止まっているのかによって、 対処方法は変わります。
この記事では、 Search Consoleを使いながら、 noindex、robots.txt、canonical、サイトマップ、 重複URLなど、 インデックスされない原因を順番に切り分けます。
インデックスとは?
インデックスとは、 Googleがページの内容を把握し、 検索結果へ表示する候補として 検索インデックスへ登録することです。
ページを公開しただけで、 自動的にすぐ検索結果へ表示されるわけではありません。
一般的には、 ページを発見し、 Googlebotがクロールし、 内容やURLの関係を確認したうえで インデックスの判断が行われます。
発見
URLの存在を Googleが知る。
クロール
ページへアクセスし 内容を読む。
インデックス
検索インデックスへ 登録する。
検索表示
検索語に応じて 表示候補になる。
「検索に出ない」ときは、 発見・クロール・インデックス・順位 のどこに問題があるか を分けて考えます。
最初にSearch Consoleの
URL検査をする
インデックスされない原因を調べるときは、 まずSearch ConsoleのURL検査を使います。
対象URLを入力すると、 GoogleがそのURLを認識しているか、 インデックスされているか、 クロールや正規化に問題がないかを確認できます。
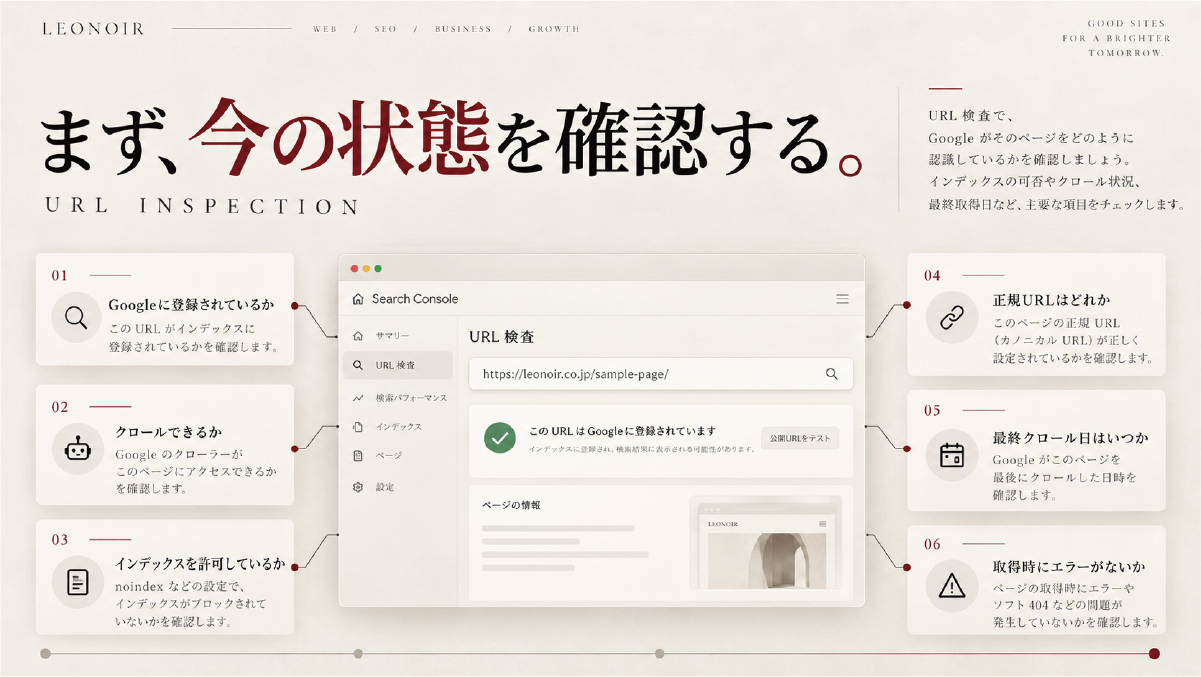
Googleに登録されているか
クロールできるか
インデックスを許可しているか
正規URLはどれか
最終クロール日はいつか
取得時にエラーがないか
GoogleにURLを
発見されていない
新しく公開したページは、 GoogleがまだURLの存在を把握していない場合があります。
特に、 他ページから内部リンクされていないページや、 サイトマップにも含まれていないページは、 発見まで時間がかかることがあります。
内部リンク
既存ページから 新ページへリンクする。
XMLサイトマップ
インデックスさせたい URLを掲載する。
URL検査
必要に応じて 登録をリクエストする。
インデックス登録リクエストは、 インデックスを保証する機能ではありません。 まずクロール・ページ内容・URL設計に問題がないかを確認します。
robots.txtで
クロールを止めていない?
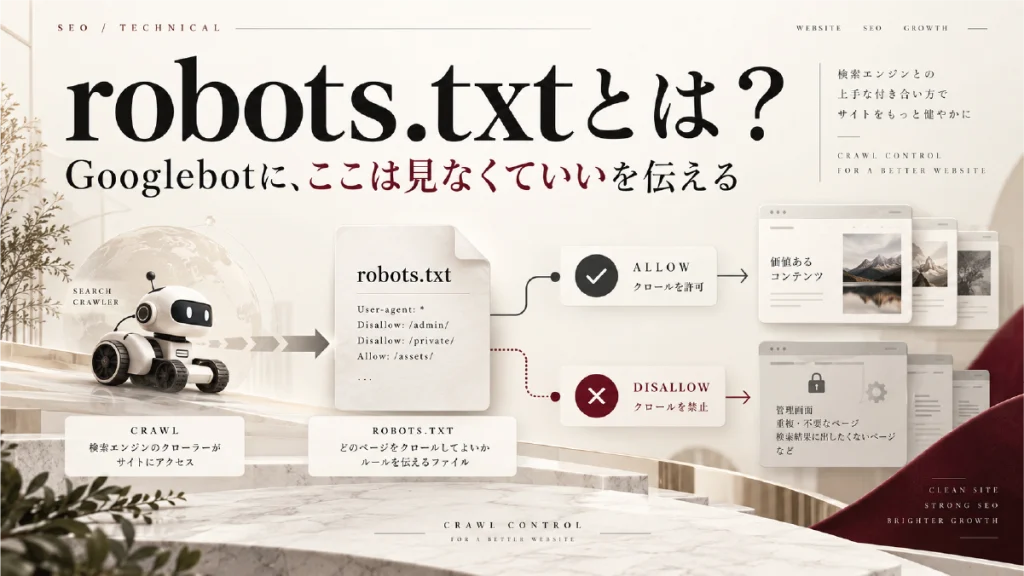
robots.txtは、 検索エンジンのクローラに対して、 特定のURLやディレクトリをクロールしないよう伝えるためのファイルです。
インデックスさせたいページを誤ってブロックしていると、 Googleがページ内容を読み取れません。
robots.txtは、 検索結果から確実にページを削除するための仕組みではありません。
User-agent: *
Disallow: /private/クロールを制御
Googlebotが ページを読むことを制御する。
インデックスを制御
Google検索結果へ ページを登録しないよう伝える。
noindexが
入っていない?
noindexは、 ページをGoogle検索のインデックスへ登録しないよう伝える指示です。
公開前のテスト環境や、 SEOプラグインの設定をそのまま引き継いだ場合などに、 意図せずnoindexが残っていることがあります。
<meta name="robots" content="noindex">robots.txtでページをブロックすると、 Googleがページをクロールできず、 ページ内のnoindexを確認できない場合があります。
別URLが正規ページに
なっていない?
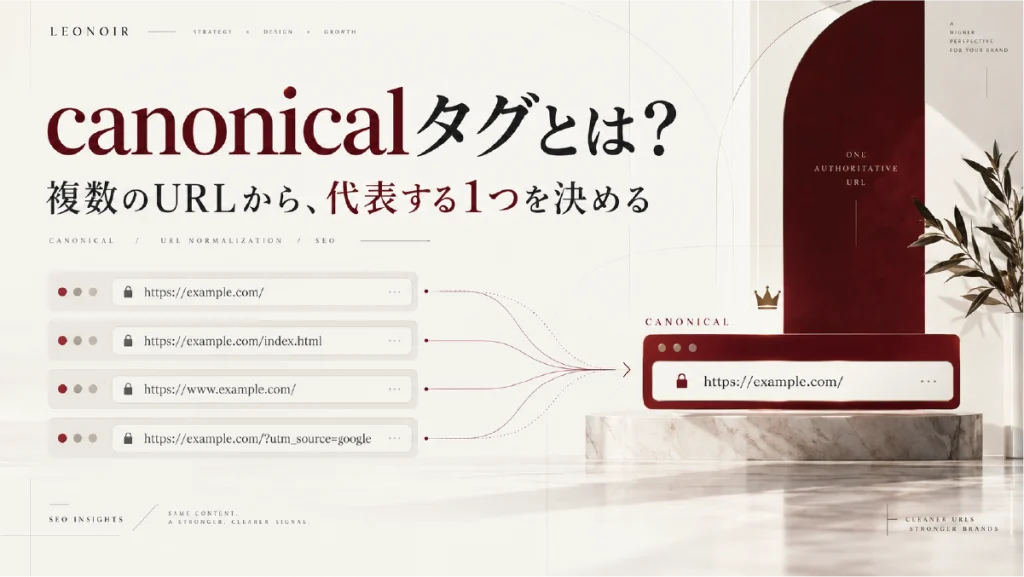
内容が同じ、または非常によく似たURLが複数ある場合、 Googleはその中から代表となる正規URLを選びます。
そのため、 確認しているURL自体がインデックスされず、 別URLが正規ページとして登録されている場合があります。
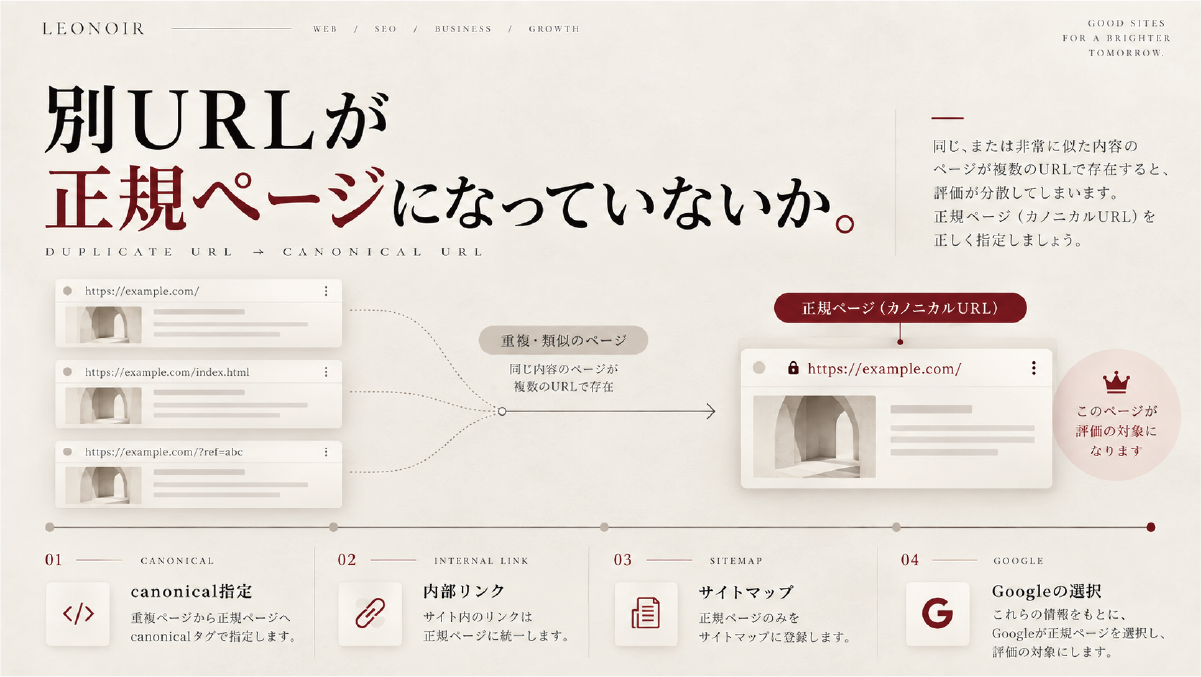
canonical指定
意図したURLを 指定しているか。
内部リンク
別URLへ リンクしていないか。
サイトマップ
正規URLだけが 掲載されているか。
Googleの選択
Search Consoleで 実際の正規URLを確認する。
クロール済みなのに
インデックスされない
Search Consoleでは、 Googleがページをクロールしたものの、 現時点ではインデックスへ登録していない状態が表示されることがあります。
この場合、 robots.txtやnoindexだけが原因とは限りません。
類似ページとの重複、 ページの独自性、 サイト内での重要度、 内部リンクなども含めて確認します。
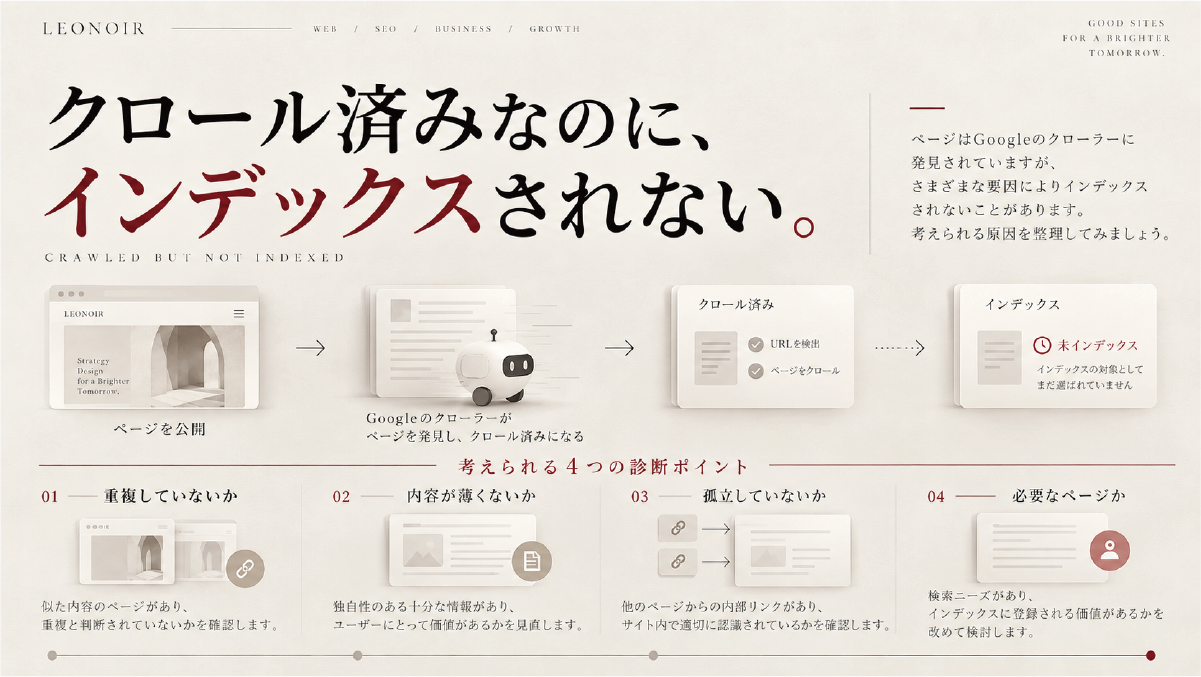
重複していないか
他ページと内容が ほぼ同じではないか。
内容が薄くないか
検索者へ提供する 独自の情報があるか。
孤立していないか
サイト内から 内部リンクされているか。
必要なページか
サイト内での役割が 明確になっているか。
XMLサイトマップも
確認する
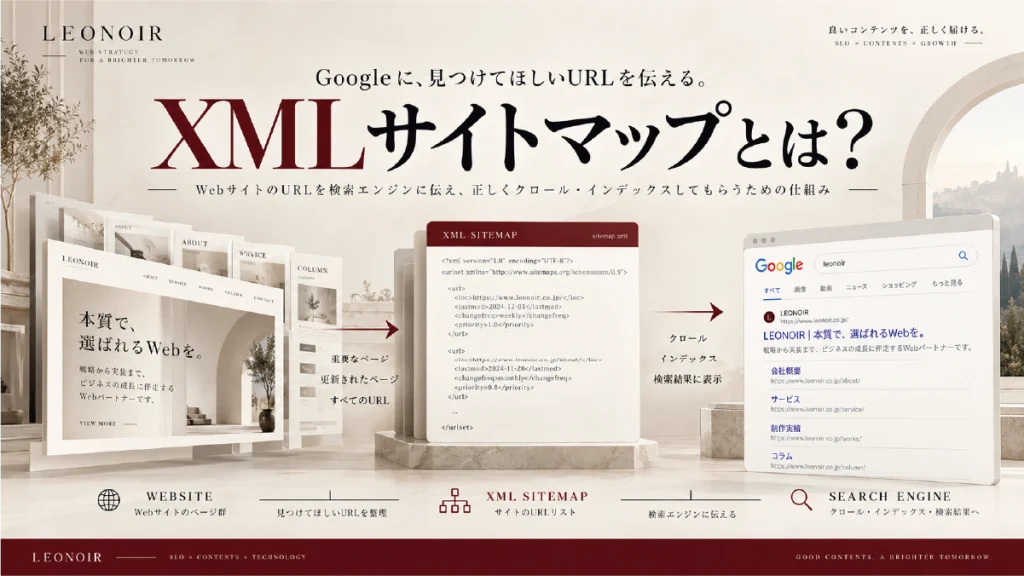
XMLサイトマップは、 GoogleにクロールしてほしいURLを伝えるための方法の一つです。
Search Consoleでは、 サイトマップが正常に取得されているかを確認できます。
サイトマップには、 基本的にインデックスさせたい正規URLを掲載します。
取得できる?
サイトマップ自体に エラーがないか。
URLは正しい?
古いURLや リダイレクトURLがないか。
noindexはない?
インデックス不可URLを 含めていないか。
canonicalは一致?
正規URLと サイトマップURLを揃える。
修正したら
どうすればいい?
原因を修正したあと、 Googleの再クロールや再処理には時間がかかる場合があります。
必要に応じてURL検査から インデックス登録をリクエストし、 ページのインデックス登録レポートで状態を確認します。
サイトマップや内部リンクも整え、 Googleが継続してページを発見できる状態にしておきます。
原因を修正
URL検査
必要なら登録リクエスト
一定期間待つ
再確認
新しいページや変更直後のページは、 Google側の再クロールや再処理に時間がかかる場合があります。 修正直後に何度も設定を変え続けず、 一定期間を置いて再確認する ことも大切です。
インデックス登録について
よくある質問
記事を公開したら何日でGoogleに登録されますか? +
一律の日数はありません。 Googleによる発見やクロールのタイミング、 サイトの状態などによって異なります。 公開直後の場合は、少し時間を置いて確認します。
インデックス登録をリクエストすれば必ず登録されますか? +
必ず登録されるわけではありません。 リクエストはGoogleに再確認を促すものであり、 最終的なインデックス登録はGoogle側で判断されます。
robots.txtとnoindexは同じですか? +
違います。 robots.txtは主にクロール制御、 noindexは検索インデックスへの登録を制御するために使います。
「クロール済み – インデックス未登録」はエラーですか? +
必ずしも技術的なエラーとは限りません。 Googleがページをクロールしたものの、 現時点ではインデックスしていない状態なので、 重複・内容・内部リンク・ページの役割などを確認します。
検索結果に出ない=インデックスされていないということですか? +
必ずしもそうではありません。 インデックスされていても、 検索順位が低いため見つけにくい場合があります。 Search ConsoleのURL検査で実際の登録状況を確認します。
SUMMARY
「出ない」ではなく、
どこで止まっているかを見る。
Google検索にページが表示されない原因は、 一つではありません。
URLがまだ発見されていない、 robots.txtでクロールできない、 noindexが入っている、 別URLが正規ページになっているなど、 状態によって原因は異なります。
まずSearch ConsoleのURL検査で 現在の状態を確認します。
そのうえで、 技術設定、URL設計、内部リンク、 コンテンツの役割まで順番に確認することが重要です。
状態確認
クロール確認
noindex確認
正規URL確認
再確認
記事を書く前に、
Googleが読める状態をつくる。
LEONOIRでは、 Search Console・インデックス・canonical・robots.txtなどの 技術的なSEOから、 コンテンツ・内部リンク・サイト構造まで Webサイト全体の改善をご相談いただけます。